클로드 코드로 영상 속 얼굴 블러·모자이크하는 법
고정된 박스 하나를 블러하는 건 ffmpeg 명령 한 줄이에요. 그런데 사람이 움직이거나 장면이 바뀌면 바로 어긋나요. 이 가이드에서는 장면이 세 번 바뀌는 40초짜리 인터뷰에서 두 사람 중 한 명만 가려요. 클로드 코드가 모든 프레임에서 얼굴을 찾고, 셔츠 색으로 인터뷰어를 골라내고, 장면마다 따라가면서 블러 버전과 모자이크 버전을 만들어 비교해요. 아래 명령과 숫자, 화면은 모두 실제로 돌린 결과예요.
발행일:
작업할 영상
영국 왕립학회(The Royal Society)의 “Interview on extreme weather with physical geographer Hannah Cloke”에서 2분 24초부터 3분 4초까지 40초를 썼어요. 원본은 CC BY 3.0으로 공개돼 있어서, 영국 왕립학회를 출처로 밝히고, 라이선스 링크를 걸고, 바꿨다는 걸 적으면 자르고 고쳐서 다시 올려도 돼요. 1920 × 1080에 초당 25프레임이라 프레임은 1,000장이에요.
영상에는 두 사람이 나와요. 해나 클로크(Hannah Cloke)와 노란 셔츠를 입은 인터뷰어예요. 목표는 인터뷰어의 얼굴만 가리고 해나의 얼굴은 그대로 두는 거예요. 장면은 세 번 바뀌어요. 해나 클로즈업, 두 사람이 다 나오는 와이드 숏, 인터뷰어 클로즈업, 다시 해나 순서예요.
모든 작업은 Mac에서 Homebrew로 설치한 ffmpeg 9.0.2와 uv로 실행한 OpenCV 5.0.0으로 했어요. 아래 명령과 출력, 이미지는 그때 나온 그대로예요.
준비물
Homebrew가 깔린 Mac, 본인 계정으로 로그인한 클로드 코드, 영상을 넣어 둔 폴더가 필요해요. Homebrew로 ffmpeg와 uv를 설치해요. uv는 파이썬 스크립트를 필요한 패키지와 함께 바로 실행해 줘서, 가상 환경을 따로 만들 필요가 없어요.
brew install ffmpeg uv얼굴을 찾으려면 검출 모델이 있어야 해요. YuNet은 OpenCV 프로젝트에서 만든 작은 얼굴 검출기로, MIT 라이선스이고 크기는 230KB 정도예요.
curl -L -o face_detection_yunet_2023mar.onnx "https://github.com/opencv/opencv_zoo/raw/main/models/face_detection_yunet/face_detection_yunet_2023mar.onnx"1. 구간 자르고 장면 전환 찾기
먼저 작업할 구간을 잘라요. 첫 프레임부터 깔끔하게 시작하도록 다시 인코딩해요.
Claude Code
interview.webm에서 2:24부터 3:04까지 clip.mp4로 잘라 줘. 그다음 장면이 바뀌는 곳을 알려 줘.
ffmpeg -ss 144 -to 184 -i interview.webm -c:v libx264 -crf 18 -preset medium -pix_fmt yuv420p -c:a aac -b:a 160k -movflags +faststart clip.mp4ffmpeg -nostats -i clip.mp4 -an -vf "select='gt(scene,0.3)',metadata=print:file=-" -f null - 2>/dev/null | grep pts_timeframe:0 pts:43520 pts_time:3.4 frame:1 pts:354304 pts_time:27.68 frame:2 pts:476672 pts_time:37.24
scene 필터는 프레임마다 앞 프레임과 얼마나 다른지 점수를 매기고, select가 0.3을 넘는 프레임만 남겨요. 초당 25프레임이니 장면 전환은 85, 692, 931번째 프레임이에요. 이 숫자는 4단계에서 다시 써요. 장면이 바뀌면 사람이 화면 반대편으로 옮겨 갈 수 있어서, 사람을 따라가는 처리는 거기서 처음부터 다시 시작해야 해요.
2. 빠른 방법: 고정 박스
가릴 대상이 움직이지 않는다면, 예를 들어 주차된 차의 번호판이나 고정된 화면 속 모니터라면 고정 박스로 충분해요. ffmpeg가 박스를 잘라 블러하고 원래 자리에 다시 얹어요. 아래 박스는 와이드 숏에서 인터뷰어 얼굴이 있는 자리예요.
ffmpeg -i clip.mp4 -filter_complex "[0:v]crop=100:160:484:220,boxblur=20:3[face];[0:v][face]overlay=484:220" \ -c:v libx264 -crf 18 -pix_fmt yuv420p -c:a copy -movflags +faststart box.mp4crop=100:160:484:220은 왼쪽에서 484픽셀, 위에서 220픽셀 떨어진 곳부터 100 × 160 박스를 잘라요. boxblur=20:3은 반경 20으로 세 번 흐리고, overlay가 같은 자리에 다시 얹어요. 인터뷰어가 거의 움직이지 않는 와이드 숏에서는 잘 맞아요. 하지만 인터뷰어 클로즈업에서는 얼굴이 다른 곳에 있어서 그대로 드러나고, 해나 장면에서는 책장 한쪽이 흐려져 있어요. 사람을 따라가는 박스를 만들려면 프레임마다 얼굴이 어디 있는지 알아야 해요.
3. 모든 얼굴 찾기
클로드 코드가 스크립트를 하나 짰어요. 모든 프레임에 YuNet을 돌려 얼굴마다 박스와 점수를 파일에 저장하고, 노란 셔츠 위에 있는 얼굴을 표시해요.
Claude Code
YuNet으로 clip.mp4의 모든 프레임에서 얼굴을 찾아서 faces.json에 저장해 줘. 가릴 사람은 노란 셔츠를 입었으니까 노란색 위에 있는 얼굴을 표시해 줘.
"""Find the faces in every frame of a video and mark the one wearing yellow.Usage: faces.py clip.mp4 faces.json"""import jsonimport sysimport cv2import numpy as npsrc, out = sys.argv[1], sys.argv[2]video = cv2.VideoCapture(src)width = int(video.get(cv2.CAP_PROP_FRAME_WIDTH))height = int(video.get(cv2.CAP_PROP_FRAME_HEIGHT))detector = cv2.FaceDetectorYN.create( "face_detection_yunet_2023mar.onnx", "", (width, height), score_threshold=0.6)def shirt(frame, x, y, w, h): """Median hue and saturation of the area under the face, where the shirt is.""" top, bottom = min(height, y + int(h * 1.3)), min(height, y + int(h * 2.3)) left, right = max(0, x), min(width, x + w) if bottom <= top or right <= left: return 0, 0 hsv = cv2.cvtColor(frame[top:bottom, left:right], cv2.COLOR_BGR2HSV) return int(np.median(hsv[..., 0])), int(np.median(hsv[..., 1]))frames = []while True: ok, frame = video.read() if not ok: break _, found = detector.detect(frame) faces = [] for face in found if found is not None else []: x, y, w, h = (int(v) for v in face[:4]) hue, sat = shirt(frame, x, y, w, h) faces.append( { "box": [x, y, w, h], "score": round(float(face[14]), 2), "yellow": 20 <= hue <= 35 and sat >= 100, } ) frames.append(faces)json.dump({"width": width, "height": height, "frames": frames}, open(out, "w"))counts = {}for faces in frames: key = (len(faces), sum(f["yellow"] for f in faces)) counts[key] = counts.get(key, 0) + 1print(f"{len(frames)} frames")for (n, yellow), count in sorted(counts.items()): print(f" {count:4} frames: {n} face(s), {yellow} in yellow")uv run --with opencv-python-headless faces.py clip.mp4 faces.json1000 frames
158 frames: 1 face(s), 0 in yellow
177 frames: 1 face(s), 1 in yellow
3 frames: 2 face(s), 0 in yellow
481 frames: 2 face(s), 1 in yellow
3 frames: 2 face(s), 2 in yellow
178 frames: 3 face(s), 1 in yellow1,000프레임에 22초 걸렸어요. HSV 색 공간에서 색상(hue)은 어떤 색인지, 채도(saturation)는 얼마나 진한지를 나타내요. 스크립트는 얼굴 조금 아래, 셔츠가 있을 자리를 보고, 색상 중앙값이 OpenCV 기준(0~179)으로 20~35 사이이고 채도가 100 이상이면 노란 셔츠로 봐요. 해나의 흰 티셔츠와 파란 벽은 통과하지 못하고, 노란 셔츠만 통과해요.
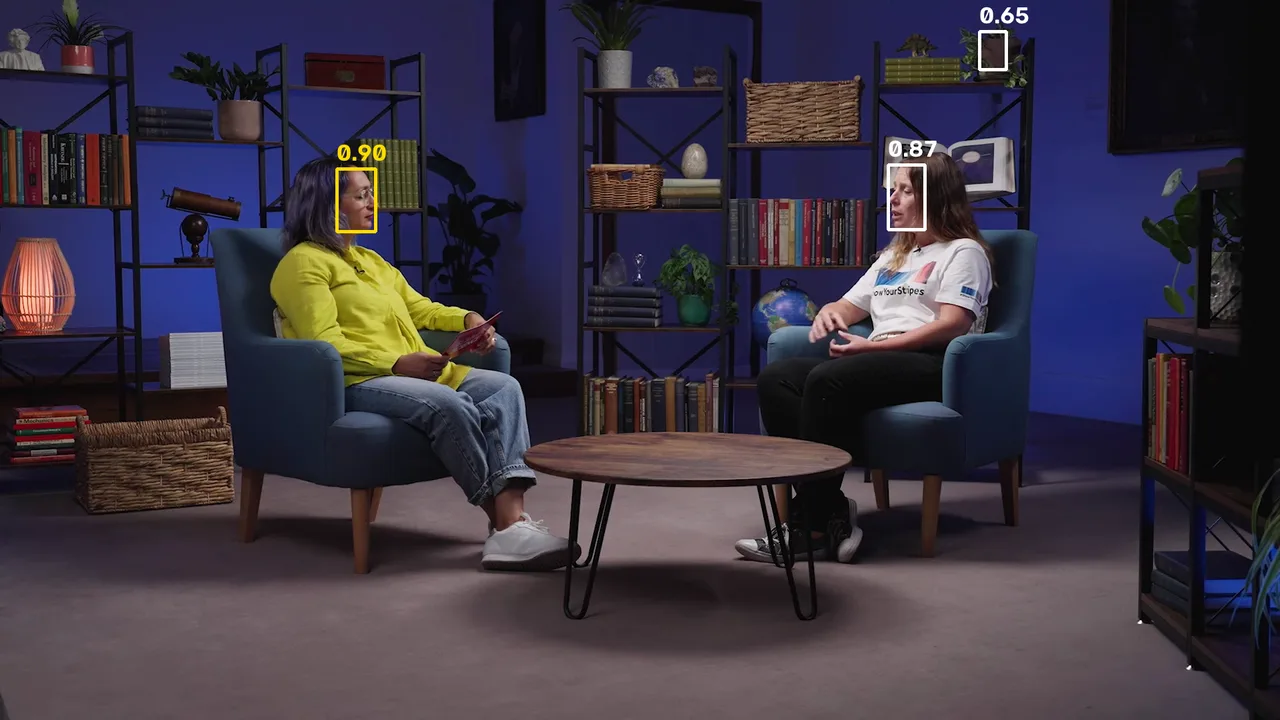
집계를 보면 검출기가 정확하지 않다는 걸 알 수 있어요. 얼굴이 세 개인 프레임이 178장인데, 세 번째는 선반 위 물체가 얼굴처럼 보여서 0.65점을 받은 거예요. 얼굴 두 개를 찾았는데 노란 셔츠가 없는 프레임이 3장, 노란 셔츠가 둘인 프레임도 3장 있어요. 그래서 다음 단계에서는 프레임마다 노란 얼굴을 무작정 고르지 않고, 한 얼굴을 시간 순서대로 따라가요.
4. 따라가면서 얼굴 가리기
두 번째 스크립트는 faces.json을 읽어 프레임마다 박스를 하나 고르고 가림 처리를 그려요. 프레임마다 노란 셔츠 얼굴 중 앞 프레임 위치와 가장 가까운 걸 골라요. 노란 셔츠 얼굴을 못 찾으면 마지막 박스를 최대 12프레임, 0.5초 동안 유지해서, 검출기가 한 프레임 놓쳤다고 얼굴이 번쩍 드러나지 않게 해요. 장면이 바뀌는 곳에서는 위치를 잊어요. 박스는 앞뒤 두 프레임씩과 평균을 내서 떨리지 않게 하고, 머리카락과 얼굴 가장자리까지 덮이도록 사방으로 35%씩 키운 다음 블러나 모자이크를 해요.
Claude Code
faces.json을 써서 clip.mp4에서 노란 셔츠 입은 사람 얼굴을 가려 줘. blur.mp4와 pixelate.mp4 두 개로. 프레임마다 따라가고, 못 찾으면 잠깐 박스를 유지하고, 85, 692, 931 장면 전환은 넘어가지 않게 해 줘.
"""Hide the face in yellow: follow it through faces.json and blur or pixelate it.Usage: hide.py clip.mp4 faces.json blur|pixelate out.mp4 85,692,931The last argument is the frames where the shot changes; a box never carries across one."""import jsonimport subprocessimport sysimport cv2import numpy as npsrc, faces_path, style, out = sys.argv[1:5]cuts = {int(f) for f in sys.argv[5].split(",")}data = json.load(open(faces_path))width, height = data["width"], data["height"]HOLD = 12 # frames to keep the last box when the face isn't foundPAD = 0.35 # grow the box by this much of its size on every sideSMOOTH = 2 # average each box with this many frames on either sidedef center(box): x, y, w, h = box return x + w / 2, y + h / 2# 1. Pick the face in yellow in each frame, nearest to where it was before.track, last, missed, held = [], None, 0, 0for i, faces in enumerate(data["frames"]): if i in cuts: last = None yellow = [f["box"] for f in faces if f["yellow"]] if last is not None and yellow: lx, ly = center(last) yellow.sort(key=lambda b: (center(b)[0] - lx) ** 2 + (center(b)[1] - ly) ** 2) if yellow: last, missed = yellow[0], 0 elif last is not None and missed < HOLD: missed += 1 held += 1 else: last = None track.append(last)# 2. Smooth the boxes so the cover doesn't jitter, without crossing a cut.smoothed = []for i, box in enumerate(track): if box is None: smoothed.append(None) continue lo = max([0] + [c for c in cuts if c <= i]) hi = min([len(track)] + [c for c in cuts if c > i]) near = [b for b in track[max(lo, i - SMOOTH) : min(hi, i + SMOOTH + 1)] if b is not None] smoothed.append([sum(b[k] for b in near) / len(near) for k in range(4)])covered = sum(b is not None for b in smoothed)print(f"{covered} of {len(smoothed)} frames covered, {held} held from the frame before")def hide(frame, box): x, y, w, h = box x0, y0 = max(0, int(x - w * PAD)), max(0, int(y - h * PAD)) x1, y1 = min(width, int(x + w * (1 + PAD))), min(height, int(y + h * (1 + PAD))) region = frame[y0:y1, x0:x1] rw, rh = x1 - x0, y1 - y0 if style == "pixelate": cells = 8 # blocks across the face, whatever its size small = cv2.resize(region, (cells, max(1, rh * cells // rw)), interpolation=cv2.INTER_AREA) frame[y0:y1, x0:x1] = cv2.resize(small, (rw, rh), interpolation=cv2.INTER_NEAREST) return k = max(3, (rw // 2) | 1) blurred = cv2.GaussianBlur(region, (k, k), 0) mask = np.zeros((rh, rw), np.float32) cv2.ellipse(mask, (rw // 2, rh // 2), (rw // 2, rh // 2), 0, 0, 360, 1.0, -1) mask = cv2.GaussianBlur(mask, (0, 0), rw / 20)[..., None] frame[y0:y1, x0:x1] = (blurred * mask + region * (1 - mask)).astype(np.uint8)# 3. Draw each frame and hand it to ffmpeg, which adds the original sound.encoder = subprocess.Popen( ["ffmpeg", "-v", "error", "-y", "-f", "rawvideo", "-pix_fmt", "bgr24", "-s", f"{width}x{height}", "-r", "25", "-i", "-", "-i", src, "-map", "0:v", "-map", "1:a", "-c:v", "libx264", "-crf", "18", "-pix_fmt", "yuv420p", "-c:a", "copy", "-movflags", "+faststart", out], stdin=subprocess.PIPE,)video = cv2.VideoCapture(src)for box in smoothed: ok, frame = video.read() if not ok: break if box is not None: hide(frame, box) encoder.stdin.write(frame.tobytes())encoder.stdin.close()encoder.wait()for style in blur pixelate; do uv run --with opencv-python-headless hide.py clip.mp4 faces.json $style $style.mp4 85,692,931done846 of 1000 frames covered, 7 held from the frame before 846 of 1000 frames covered, 7 held from the frame before
가려진 프레임은 846장이에요. 인터뷰어가 나오는 두 장면, 와이드 숏 607장과 인터뷰어 클로즈업 239장이에요. 그중 7장은 검출기가 못 찾아서 박스를 유지한 프레임이에요. 버전마다 6초쯤 걸렸어요. 프레임은 파이프로 OpenCV에서 ffmpeg로 바로 넘어가고, ffmpeg가 원래 소리를 다시 인코딩하지 않고 붙여요.
첫 실행에서 알아 둘 만한 실수가 두 개 있었어요. 장면 전환 위치를 스크립트에 넘기기 전에는 유지하던 박스가 전환 뒤로 12프레임 넘어가서 해나 클로즈업의 얼굴 일부를 흐렸어요. 그리고 처음 블러 세기는 박스 너비의 3분의 1이었는데, 입 모양이 읽힐 정도였어요. 너비의 절반으로 올리니 가려졌어요.
5. 모든 장면 확인하기
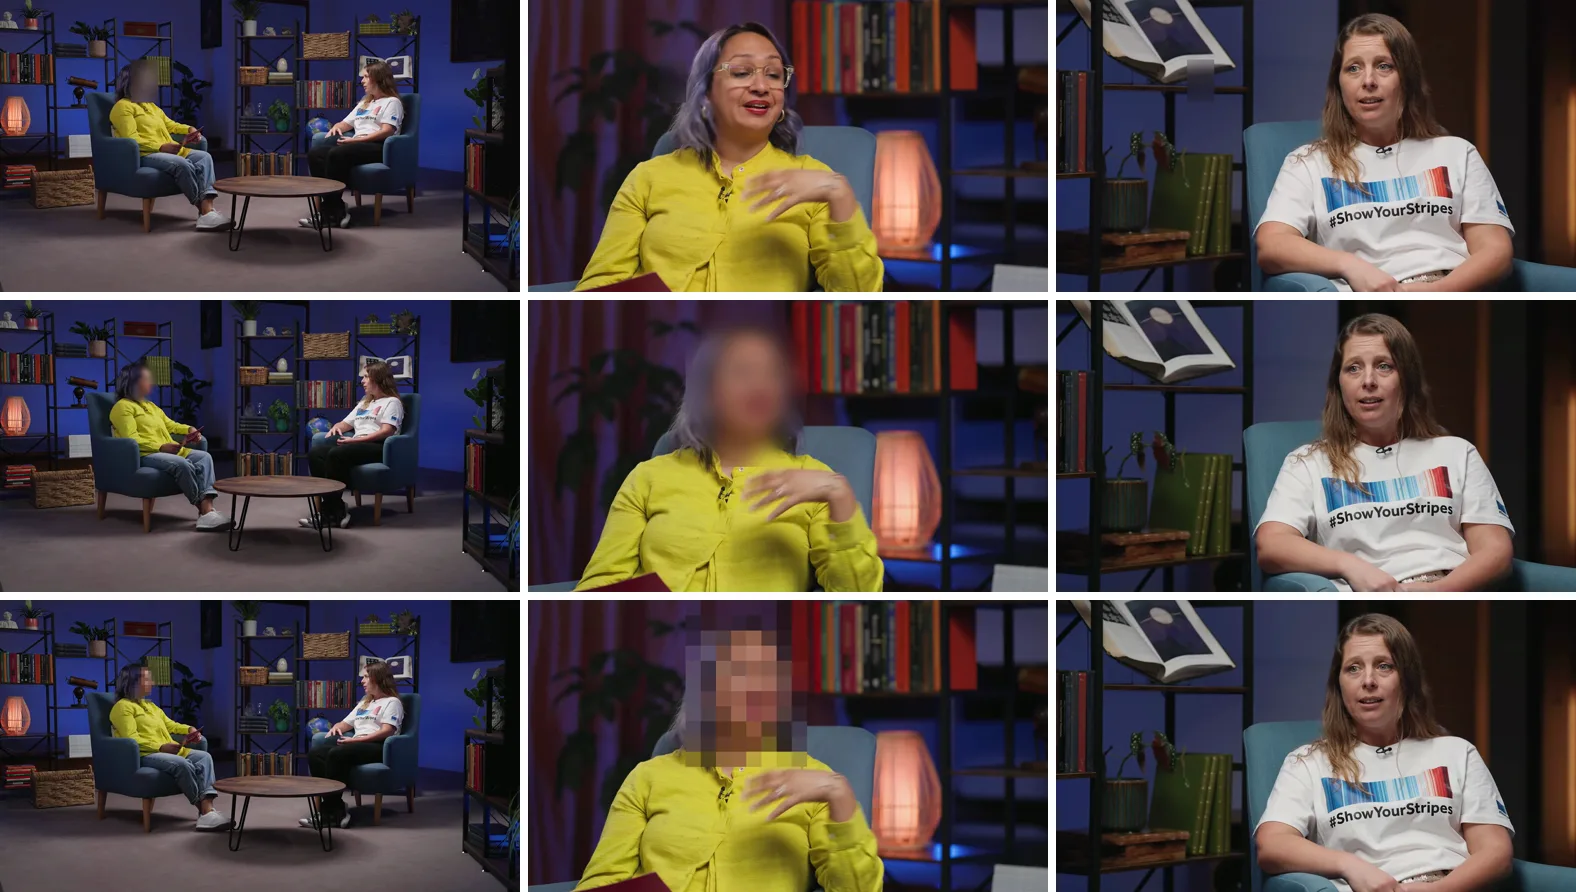
한 프레임에서 잘 가려졌어도 다른 프레임에서 빗나갈 수 있어요. 그래서 여러 프레임을 한 번에 보면서 확인해요. 클로드 코드가 인터뷰어 클로즈업에서 10프레임마다 한 장씩 뽑아 한 장에 모았어요.
ffmpeg -v error -i blur.mp4 -vf "select='between(n,692,930)*not(mod(n-692,10))',scale=320:-2,tile=6x4" -frames:v 1 -fps_mode vfr close-tiles.png모은 24장 모두 얼굴이 가려져 있었어요. 와이드 숏도 26프레임마다 뽑아 같은 식으로 봤고, 해나 장면 두 개에는 아무것도 덮이지 않은 걸 확인했어요. 세 버전을 장면별로 나란히 놓으면 이래요.
6. 블러냐 모자이크냐
두 버전은 같은 박스에서 나왔으니, 다른 건 얼굴을 가리는 방식뿐이에요. 모자이크 버전은 이래요.
블러는 타원 가장자리에서 자연스럽게 흐려져서 부드럽게 배경에 묻혀요. 모자이크는 경계가 분명한 네모 블록이라 뭔가를 가렸다는 게 확실히 보여요. 모자이크 칸은 픽셀이 아니라 얼굴 너비 기준으로 8칸이에요. 처음엔 12픽셀 칸으로 했더니 와이드 숏에서는 가려졌지만, 얼굴이 몇 배 큰 클로즈업에서는 알아볼 수 있었어요. 어느 쪽이 맞는지는 영상에 대한 선택이에요. 둘 다 만들어 뒀으니 나란히 보면서 고르면 돼요.
7. 출처 표시하기
CC BY는 제목, 만든 사람, 라이선스 링크, 바꿨다는 표시를 요구해요. 얼굴을 가린 것도 바꾼 거니까 적어 둬요.
Footage: "Interview on extreme weather with physical geographer Hannah Cloke" by the Royal Society, CC BY 3.0, cut, and the interviewer's face blurredLicense: https://creativecommons.org/licenses/by/3.0/어려워지는 부분
검출기는 보이는 얼굴만 찾아요. 옆모습이거나, 고개를 돌렸거나, 아주 작거나, 손에 가린 얼굴은 0.5초 유지보다 길게 빠질 수 있고, 그러면 얼굴이 드러나요. 누군가를 가리는 게 중요하다면 샘플만 보지 말고 그 사람이 나오는 모든 장면의 모든 프레임을 보고, 빈 곳은 직접 메워야 해요. 박스를 더 크게, 더 오래 유지하는 쪽이 안전해요.
얼굴을 가린다고 익명이 되는 건 아니에요. 이 영상에서도 인터뷰어가 질문하는 목소리는 그대로 들려요. 목소리, 옷, 자막 속 이름, 배경의 장소로도 사람을 알아볼 수 있어요. 약한 블러는 알아볼 수 있을 만큼 복원될 수도 있으니 세게 하세요. 유튜브에 올릴 영상이라면 컴퓨터에서 YouTube 스튜디오 편집기의 얼굴 흐리게 처리 기능도 쓸 수 있어요. 얼굴을 찾아서 고른 얼굴을 따라가며 흐려 줘요. 다만 저장한 뒤에는 거기서 원본으로 되돌릴 수 없으니 원본은 따로 보관해 두세요.
컷팩(Cutfac)은 이런 영상을 위해 저희가 만드는 Mac 앱이에요. 영상마다 클로드 코드나 Codex를 실행하고, 구간을 선택하거나 화면에 박스를 그려 고칠 점을 말하면 돼요. 버전은 나란히 놓고 비교해서 고를 수 있어요. 물론 이 가이드의 내용은 컷팩 없이도 전부 할 수 있어요.
출처
- Wikimedia Commons: Interview on extreme weather with physical geographer Hannah Cloke – The Royal Society (CC BY 3.0)
- Creative Commons: Attribution 3.0 Unported (CC BY 3.0)
- Claude Code overview
- Homebrew: ffmpeg
- FFmpeg filters: select, crop, boxblur and overlay
- uv: Running scripts
- opencv-python-headless on PyPI (Apache 2.0 license)
- OpenCV Zoo: YuNet face detection model (MIT license)
- OpenCV: FaceDetectorYN class reference
- YouTube Help: Blur your videos
자주 묻는 질문
얼굴이 한자리에 있다면 그 박스를 잘라 블러하고 다시 얹으면 돼요. ffmpeg -i in.mp4 -filter_complex "[0:v]crop=100:160:484:220,boxblur=20:3[face];[0:v][face]overlay=484:220" -c:a copy out.mp4. 얼굴이 움직인다면 프레임마다 얼굴 위치가 필요해서, OpenCV의 YuNet 같은 얼굴 검출기가 있어야 해요.
모든 프레임에 얼굴 검출기를 돌리고, 앞 프레임과 가장 가까운 박스를 골라 같은 얼굴을 따라가요. 검출기가 놓친 프레임은 박스를 몇 프레임 유지하고, 장면이 바뀌면 처음부터 다시 시작해요. 그다음 프레임마다 그 박스를 가리면 돼요. 이 가이드에서는 1,000프레임 중 846프레임, 그 사람이 화면에 나온 프레임 전부를 가렸어요.
얼굴을 전부 찾은 다음, 앉은 자리나 옷처럼 바뀌지 않는 걸로 가릴 사람을 구분해요. 여기서는 가릴 사람이 노란 셔츠를 입고 있어서 스크립트가 얼굴 아래 색을 확인했어요.
둘 다 충분히 세면 얼굴을 가려요. 블러는 부드럽게 배경에 묻히고, 모자이크는 뭔가를 가렸다는 게 분명히 보여요. 모자이크 칸은 픽셀이 아니라 얼굴 너비 기준으로 정해야 클로즈업에서도 알아볼 수 없어요.
네. 컴퓨터에서 YouTube 스튜디오 편집기의 흐리게 처리 도구에 얼굴 흐리게 처리가 있어요. 영상 속 얼굴을 찾아서 고른 얼굴을 흐려 줘요. 유튜브에 올린 영상에만 쓸 수 있고, 저장한 변경은 거기서 원본으로 되돌릴 수 없어요.
그것만으로는 안 돼요. 목소리, 옷, 이름, 장소로도 사람을 알아볼 수 있고, 약한 블러는 알아볼 수 있어요. 그 사람이 나오는 모든 프레임을 확인하고, 가림을 세게 하고, 그 밖에 사람을 드러내는 게 없는지 살펴보세요.