클로드 코드로 무음 구간 자르고 점프컷 만드는 법
말하는 사람의 쉬는 구간을 잘라내는 컷편집은 짧은 영상에서 가장 흔한 편집이에요. 손으로 하면 자잘한 컷을 수없이 해야 하죠. 이 가이드에서는 인터뷰 1분에 그 작업을 해요. 클로드 코드가 ffmpeg로 쉬는 구간을 찾아 한 번에 잘라내고, 타이트한 버전과 여유 있는 버전을 만들어 비교하고, 자막과 대조해 잘린 말이 없는지 확인하고, 조각을 하나 걸러 확대해서 컷이 화면 전환처럼 보이게 해요. 아래 명령과 숫자, 화면은 모두 실제로 돌린 결과예요.
발행일:
작업할 영상
영국 왕립학회(The Royal Society)의 “Interview on extreme weather with physical geographer Hannah Cloke”에서 3분 6.5초부터 4분 7.5초까지 61초를 썼어요. 원본은 CC BY 3.0으로 공개돼 있어서, 영국 왕립학회를 출처로 밝히고, 라이선스 링크를 걸고, 바꿨다는 걸 적으면 자르고 고쳐서 다시 올려도 돼요. 1920 × 1080에 초당 25프레임이에요.
인터뷰어가 다음 홍수를 얼마나 잘 예측할 수 있냐고 묻고, 해나 클로크(Hannah Cloke)가 주로 클로즈업으로 답해요. 해나는 구절 단위로 말하고 그 사이에 짧게 숨을 쉬어요. 점프컷은 바로 이 틈을 잘라내는 거예요. 컷마다 화면이 살짝 튀고, 말은 끊김 없이 이어져요.
모든 작업은 Mac에서 Homebrew로 설치한 ffmpeg 9.0.2와 openai-whisper로 했어요. 아래 명령과 출력, 이미지는 그때 나온 그대로예요.
준비물
Homebrew가 깔린 Mac, 본인 계정으로 로그인한 클로드 코드, 작업할 폴더가 필요해요. Homebrew로 ffmpeg와, 확인 단계에서 자막을 뽑을 whisper를 설치해요.
brew install ffmpeg openai-whisper인터뷰는 위키미디어 커먼즈에서 받아요. 10분쯤, 85MB 정도예요.
curl -L -o interview.webm "https://upload.wikimedia.org/wikipedia/commons/9/99/Interview_on_extreme_weather_with_physical_geographer_Hannah_Cloke_%E2%80%93_The_Royal_Society.webm"1. 구간 자르기
먼저 작업할 구간을 잘라요. 첫 프레임부터 깔끔하게 시작하도록 다시 인코딩해요.
Claude Code
interview.webm을 3:06.5부터 4:07.5까지 잘라서 clip.mp4로 만들어 줘.
ffmpeg -ss 186.5 -to 247.5 -i interview.webm -c:v libx264 -crf 18 -preset medium -pix_fmt yuv420p -c:a aac -b:a 160k -movflags +faststart clip.mp42. 쉬는 구간 찾기
ffmpeg의 silencedetect 필터는 소리를 듣다가 정해 둔 크기보다 작은 상태가 정해 둔 시간 이상 이어지는 곳을 기록해요. 기준을 정하기 전에 클로드 코드가 volumedetect로 클립의 크기를 쟀어요. 평균은 -18.0dB, 가장 큰 순간은 -0.4dB였어요. 평균 -18dB인 말소리는 -30dB와 충분히 떨어져 있어서, 첫 시도는 -30dB에 0.3초 이상인 구간으로 했어요.
Claude Code
clip.mp4에서 말이 멈추는 구간을 찾아서 silence.log에 저장해 줘.
ffmpeg -nostats -i clip.mp4 -vn -af silencedetect=noise=-30dB:d=0.3 -f null - 2>&1 | grep -o "silence_[a-z]*: [-0-9.]*.*" > silence.loghead -6 silence.logsilence_start: 3.788292 silence_end: 4.501542 | silence_duration: 0.71325 silence_start: 7.405333 silence_end: 8.240604 | silence_duration: 0.835271 silence_start: 13.256687 silence_end: 13.596854 | silence_duration: 0.340167
0.31초에서 0.84초짜리 쉬는 구간이 14곳, 모두 합쳐 6.68초가 나왔어요. 결과를 가장 크게 바꾸는 건 기준 크기라서, 클로드 코드가 기준마다 몇 곳이 잡히는지 세어 봤어요.
for n in -25 -30 -35 -40; do echo "$n dB: $(ffmpeg -nostats -i clip.mp4 -vn -af silencedetect=noise=${n}dB:d=0.3 -f null - 2>&1 | grep -c silence_end) pauses"done-25 dB: 17 pauses -30 dB: 14 pauses -35 dB: 6 pauses -40 dB: 4 pauses
구절 사이에도 방이 완전히 조용해지진 않고 -30에서 -45dB쯤으로 떨어져요. 그래서 -35dB나 -40dB에서는 쉬는 구간 대부분이 무음으로 잡히지 않아요. -25dB에서는 말끝의 작은 소리까지 무음으로 잡히기 시작해요. -30dB는 숨 쉬는 틈만 정확히 잡았어요. 최소 길이도 마찬가지예요. -30dB에 0.2초로 하면 19곳이 잡히는데, 늘어난 5곳은 구절 안의 짧은 틈이라 자르면 안 되는 곳이에요.
3. 타이트하게, 여유 있게 잘라내기
쉬는 구간을 끝에 딱 맞춰 자르면 숨소리와 다음 말의 첫소리가 잘려요. 그래서 구간마다 양쪽을 조금 남겨 둬요. 얼마나 남길지는 취향이라, 클로드 코드가 양쪽에 0.05초씩 남긴 버전과 0.15초씩 남긴 버전을 만들었어요. 스크립트가 silence.log를 읽어 남길 부분을 계산하고, ffmpeg가 모든 조각을 한 번에 잘라 이어 붙여요.
Claude Code
silence.log에 있는 쉬는 구간을 clip.mp4에서 잘라내 줘. 구간마다 양쪽에 0.05초씩 남긴 건 tight.mp4로, 0.15초씩 남긴 건 loose.mp4로.
"""Cut the pauses out of a video, leaving PAD seconds of each pause on either side.Usage: cuts.py clip.mp4 silence.log PAD out.mp4 [ZOOM]With ZOOM, every other piece is enlarged by that much, so the jump at each cut reads as achange of framing."""import reimport subprocessimport syssrc, log, pad, out = sys.argv[1], sys.argv[2], float(sys.argv[3]), sys.argv[4]zoom = float(sys.argv[5]) if len(sys.argv) > 5 else 1.0FPS = 25FADE = 0.01 # a 10 ms fade at each joint so the sound doesn't clickduration = float( subprocess.run( ["ffprobe", "-v", "error", "-show_entries", "format=duration", "-of", "csv=p=0", src], capture_output=True, text=True, check=True, ).stdout)starts = [float(v) for v in re.findall(r"silence_start: ([\d.]+)", open(log).read())]ends = [float(v) for v in re.findall(r"silence_end: ([\d.]+)", open(log).read())]def frame(t): """Round a time to the nearest frame, so picture and sound are cut at the same place.""" return round(t * FPS) / FPS# Keep everything except the middle of each pause that's longer than the padding on both sides.keep, at, cut = [], 0.0, 0for start, end in zip(starts, ends): if end - start <= 2 * pad: continue keep.append((at, frame(start + pad))) at = frame(end - pad) cut += 1keep.append((at, duration))parts, labels = [], ""for i, (a, b) in enumerate(keep): punch = f",crop=iw/{zoom}:ih/{zoom},scale=1920:1080,setsar=1" if zoom > 1 and i % 2 else "" parts.append(f"[0:v]trim={a}:{b},setpts=PTS-STARTPTS{punch}[v{i}]") parts.append( f"[0:a]atrim={a}:{b},asetpts=PTS-STARTPTS," f"afade=t=in:d={FADE},afade=t=out:st={b - a - FADE:.3f}:d={FADE}[a{i}]" ) labels += f"[v{i}][a{i}]"parts.append(f"{labels}concat=n={len(keep)}:v=1:a=1[v][a]")subprocess.run( ["ffmpeg", "-v", "error", "-y", "-i", src, "-filter_complex", ";".join(parts), "-map", "[v]", "-map", "[a]", "-c:v", "libx264", "-crf", "18", "-pix_fmt", "yuv420p", "-c:a", "aac", "-b:a", "160k", "-movflags", "+faststart", out], check=True,)kept = sum(b - a for a, b in keep)print(f"{out}: {cut} pauses cut, {duration:.2f} s -> {kept:.2f} s ({duration - kept:.2f} s shorter)")python3 cuts.py clip.mp4 silence.log 0.05 tight.mp4python3 cuts.py clip.mp4 silence.log 0.15 loose.mp4tight.mp4: 14 pauses cut, 61.04 s -> 55.68 s (5.36 s shorter) loose.mp4: 14 pauses cut, 61.04 s -> 58.56 s (2.48 s shorter)
버전마다 7초쯤 걸렸어요. trim과 atrim이 화면과 소리에서 같은 구간을 잘라내고, concat이 순서대로 이어 붙여요. 결과를 깔끔하게 만드는 건 두 가지예요. 모든 컷을 프레임 단위로 맞춰서 화면과 소리가 같은 곳에서 잘리고 싱크가 어긋나지 않아요. 그리고 소리 조각마다 앞뒤로 10밀리초 페이드를 줘서 이음새에서 딸깍 소리가 나지 않아요.
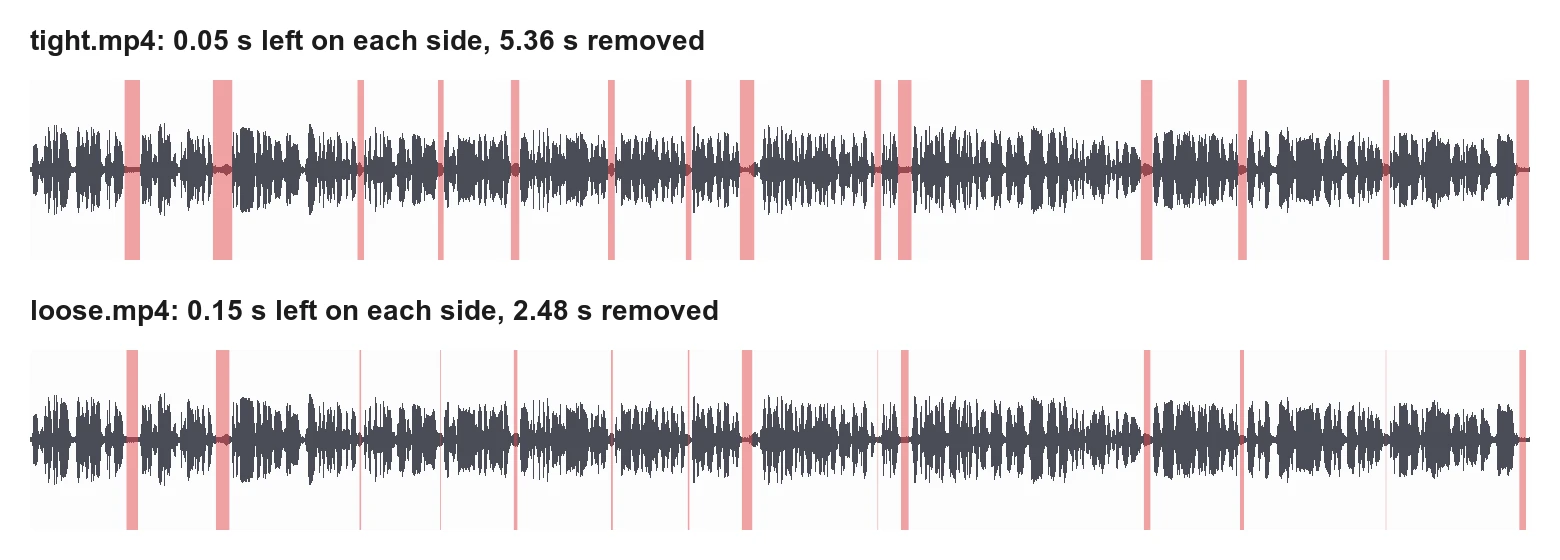
타이트한 버전은 구절이 바로 이어져서, 대부분의 토킹헤드 쇼츠처럼 빠르게 느껴져요. 여유 있는 버전은 짧은 숨이 남아 실제로 말하는 느낌에 더 가까워요. 둘 다 같은 로그에서 나왔으니, 남기는 길이를 바꾼 버전을 하나 더 만드는 것도 명령 한 줄이에요.
4. 잘린 말이 없는지 확인하기
무음 감지는 소리가 크냐 작냐만 알아요. 그래서 작게 말한 단어가 기준 아래로 떨어지면 쉬는 구간과 함께 잘릴 수 있어요. 클로드 코드가 두 가지로 확인했어요. 먼저 whisper로 세 파일을 모두 받아 적고, 단어 단위로 비교했어요.
Claude Code
tight.mp4와 loose.mp4에서 빠진 말이 없는지 확인해 줘.
whisper clip.mp4 tight.mp4 loose.mp4 --language en --output_format txt --output_dir checkfor f in tight loose; do echo "--- $f" diff <(tr -s ' \n' '\n\n' < check/clip.txt) <(tr -s ' \n' '\n\n' < check/$f.txt)done--- tight 52d51 < and 124d122 < yeah 152c150 < um --- > and --- loose 52d51 < and
차이마다 클립의 타임스탬프에서 위치를 찾아봤어요. 16.9초의 “and”와 37.2초의 “yeah”는 둘 다 잘라낸 구간 밖에 있어서 그대로 남아 있어요. whisper가 앞뒤 단어와 붙여서 들은 거예요. 45초의 “um”은 실제로 바뀐 곳이에요. 길게 끈 “음”의 작은 끝부분이 쉬는 구간 안에 있었고, 그 끝이 잘리자 whisper가 “and”로 들었어요. 이렇게 길게 끈 추임새를 줄이는 것도 타이트한 컷이 하는 일이에요.
자막도 놓치는 게 있을 수 있어서, 두 번째로 타이트한 버전이 잘라낸 구간마다 가장 큰 소리를 쟀어요.
"""Print the loudest moment of each stretch cuts.py removes, to check no speech went with it.Usage: peaks.py clip.mp4 silence.log PAD"""import reimport subprocessimport syssrc, log, pad = sys.argv[1], sys.argv[2], float(sys.argv[3])FPS = 25starts = [float(v) for v in re.findall(r"silence_start: ([\d.]+)", open(log).read())]ends = [float(v) for v in re.findall(r"silence_end: ([\d.]+)", open(log).read())]def frame(t): return round(t * FPS) / FPSfor start, end in zip(starts, ends): if end - start <= 2 * pad: continue a, b = frame(start + pad), frame(end - pad) stats = subprocess.run( ["ffmpeg", "-nostats", "-ss", str(a), "-to", str(b), "-i", src, "-vn", "-af", "aformat=channel_layouts=mono,astats", "-f", "null", "-"], capture_output=True, text=True, ).stderr peak = re.findall(r"Peak level dB: ([-\d.]+)", stats)[-1] print(f"{a:5.2f}-{b:5.2f} s peak {float(peak):.1f} dB")python3 peaks.py clip.mp4 silence.log 0.053.84- 4.44 s peak -43.7 dB 7.44- 8.20 s peak -34.6 dB 13.32-13.56 s peak -30.1 dB 16.60-16.80 s peak -31.0 dB 19.56-19.88 s peak -30.4 dB 23.52-23.76 s peak -30.5 dB 26.68-26.88 s peak -34.4 dB 28.88-29.44 s peak -31.6 dB 34.36-34.60 s peak -35.5 dB 35.32-35.84 s peak -39.0 dB 45.20-45.64 s peak -31.4 dB 49.16-49.48 s peak -33.7 dB 55.04-55.28 s peak -32.9 dB 60.48-60.96 s peak -35.4 dB
잘라낸 곳 중 -30.1dB보다 큰 소리는 없어요. 말소리 평균이 -18dB이니, 잘린 건 숨소리와 방 소리예요. 만약 말소리에 가까운 크기가 나온 구간이 있다면, 거기를 직접 들어 보면 돼요.
5. 펀치인으로 점프 숨기기
숏이 그대로인 채로 자르면, 컷 직전 프레임과 직후 프레임 사이에 머리가 살짝 움직여요. 점프컷이라는 이름도 이 작은 튐에서 왔어요. 이걸 부드럽게 하는 흔한 방법은 조각을 하나 걸러 확대해서, 컷마다 화면 구도가 바뀐 것처럼 보이게 하는 거예요. 같은 스크립트에 확대 배율을 주면 돼요. 여기서는 1.15배예요.
python3 cuts.py clip.mp4 silence.log 0.05 punch.mp4 1.15punch.mp4: 14 pauses cut, 61.04 s -> 55.68 s (5.36 s shorter)
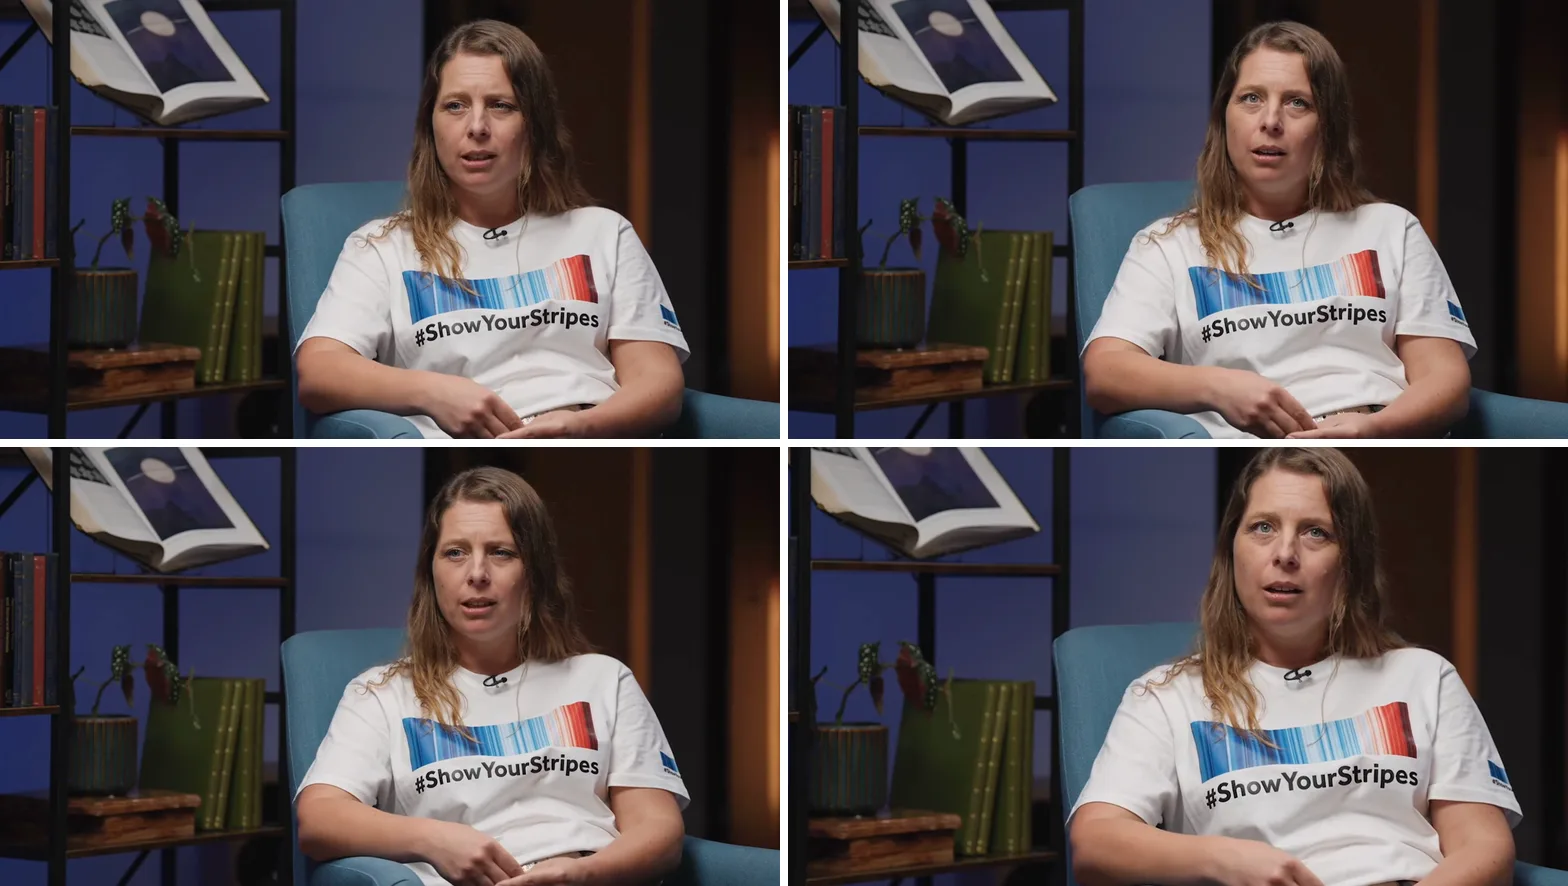
tight.mp4에서는 나머지는 그대로인 화면에서 머리만 옆으로 움직여서 눈에 걸려요. punch.mp4에서는 같은 순간에 화면 전체 크기가 바뀌어서, 움직임이 그 안에 묻혀요. 1.15배 확대는 가로세로를 13%쯤 잘라내고 남은 부분을 키우는 거라, 1080p 원본에서는 확대한 조각이 조금 흐려져요. 4K 원본이라면 그렇지 않아요.
6. 출처 표시하기
CC BY는 제목, 만든 사람, 라이선스 링크, 바꿨다는 표시를 요구해요. 쉬는 구간을 자르고 확대한 것도 바꾼 거니까 적어 둬요.
Footage: "Interview on extreme weather with physical geographer Hannah Cloke" by the Royal Society, CC BY 3.0, cut, its pauses shortened, and parts enlargedLicense: https://creativecommons.org/licenses/by/3.0/어려워지는 부분
이 인터뷰는 이미 편집된 영상이라 긴 쉬는 구간이 적었고, 타이트한 컷으로 61초 중 5.36초가 줄었어요. 생각하느라 멈추고 말을 다시 시작하는 원본 녹화라면 보통 잘라낼 게 훨씬 많아요. 다만 무음 감지는 조용한 곳만 찾아요. 시작 부분에서 인터뷰어가 “how good are we and how good are we”라고 다시 말하는데, 그 사이에 쉬는 틈이 없어서 자막을 봐야만 알 수 있어요. 크게 말한 추임새도 마찬가지예요.
기준 크기는 녹화마다 달라요. 시끄러운 방이나 목소리 아래 깔린 음악이 구절 사이를 채우면 무음 감지는 아무것도 못 찾아요. 먼저 volumedetect로 재고, 기준을 몇 개 바꿔 가며 몇 곳이 잡히는지 세고, 올리기 전에 자막과 대조해 확인하세요.
컷팩(Cutfac)은 이런 영상을 위해 저희가 만드는 Mac 앱이에요. 영상마다 클로드 코드나 Codex를 실행하고, 구간을 선택하거나 화면에 박스를 그려 고칠 점을 말하면 돼요. 버전은 나란히 놓고 비교해서 고를 수 있어요. 물론 이 가이드의 내용은 컷팩 없이도 전부 할 수 있어요.
출처
- Wikimedia Commons: Interview on extreme weather with physical geographer Hannah Cloke – The Royal Society (CC BY 3.0)
- Creative Commons: Attribution 3.0 Unported (CC BY 3.0)
- OpenAI Whisper (MIT license)
- Homebrew: openai-whisper
- Claude Code overview
- Homebrew: ffmpeg
- FFmpeg filters: silencedetect, trim, atrim, afade, concat, crop and astats
자주 묻는 질문
silencedetect로 쉬는 구간을 찾아요. 예를 들면 -af silencedetect=noise=-30dB:d=0.3이에요. 그다음 그 사이를 화면은 trim, 소리는 atrim으로 남기고 concat으로 이어 붙여요. ffmpeg의 silenceremove 필터는 소리만 줄여서 화면과 싱크가 어긋나요.
말소리와 방이 얼마나 큰지에 따라 달라요. volumedetect로 클립을 재고, 기준 몇 개로 쉬는 구간이 몇 곳 잡히는지 세어 보세요. 이 가이드에서는 말소리 평균이 -18dB였고, -30dB에서 14곳이 잡혔어요. 구절 사이 방 소리가 -30에서 -45dB쯤이라 -40dB에서는 4곳만 잡혔어요.
숨소리와 다음 말의 첫소리가 잘리지 않을 만큼이요. 양쪽에 0.05초씩 남기면 대부분의 쇼츠처럼 빠르게 이어지고, 0.15초씩 남기면 짧은 숨이 남아요. 둘 다 만들어 보고 고르세요.
조각을 하나 걸러 확대하면 돼요. 여기서는 1.15배로 했어요. 그러면 컷마다 화면 구도가 바뀐 것처럼 보여요. 다른 숏으로 넘어가거나 이음새를 다른 영상으로 덮는 방법도 있어요.
단어가 기준보다 작으면 잘릴 수 있어요. 결과와 원본의 자막을 비교하고, 잘라낸 구간마다 가장 큰 소리를 재 보세요. 이 가이드에서는 잘라낸 곳 중 -30.1dB보다 큰 소리가 없었어요.
무음 감지만으로는 안 돼요. 조용한 곳만 찾으니까 크게 말한 단어나 두 번 한 말은 남아요. 그런 건 단어별 타이밍이 있는 자막이 있어야 에이전트가 찾아서 자를 수 있어요.